

-
-
信息发布
-
门禁考勤
-
访客预约
-
会议预约
-
智慧监控
-
企业数智化
-
信息发布
-
-
公司介绍
-
企业动态
-
招标公告
-
联系我们
-
公司介绍
6TOPS 算力意味着什么?视美泰 AI 主板算力实测场景与选型拆解
一、先把"TOPS"这个单位说清楚
TOPS 是 Tera Operations Per Second 的缩写,即每秒万亿次运算。它是衡量 NPU(神经网络处理单元)峰值算力的通用指标。
但必须提前说明一个行业共识:标称 TOPS 不等于实际可用算力。 两点原因:
第一,有效算力取决于数据类型与算子支持度。 INT8 精度下的算力通常高于 FP16。如果模型中的算子无法被 NPU 原生支持,需要图切分后交给 CPU 执行,实际吞吐会大幅下降。所以看 NPU 不能只看 TOPS 数字,还要看它对目标模型架构的原生加速能力。
第二,端侧推理的瓶颈往往在内存带宽,而不在 NPU。 大模型推理属于内存访问密集型任务。NPU 算力再高,如果内存带宽跟不上,NPU 会长期处于"等数据"状态。这就是为什么同样是 6TOPS,搭配 LPDDR5 的 RK3588 和搭配 LPDDR4X 的 RK3576,在大模型场景下的表现会有差别。
不过抛开这些限定条件,6TOPS 这个量级在嵌入式端侧 AI 领域是一个明确的分水岭。它标志着设备从"能跑轻量视觉算法"跨越到"能承担真实 AI 业务负载"。

二、6TOPS 能跑什么:一个能力清单
基于视美泰 RK3576 与 RK3588 平台主板的实际描述,6TOPS 算力可以支撑以下业务在终端本地运行:
视觉类:
人体姿态识别与关键点检测
动作矫正判断(运动魔镜、AI 健身镜核心能力)
人体体测算法(BMI、体脂、体态分析等)
人脸检测与人脸比对
车牌识别
客流统计
视频结构化分析
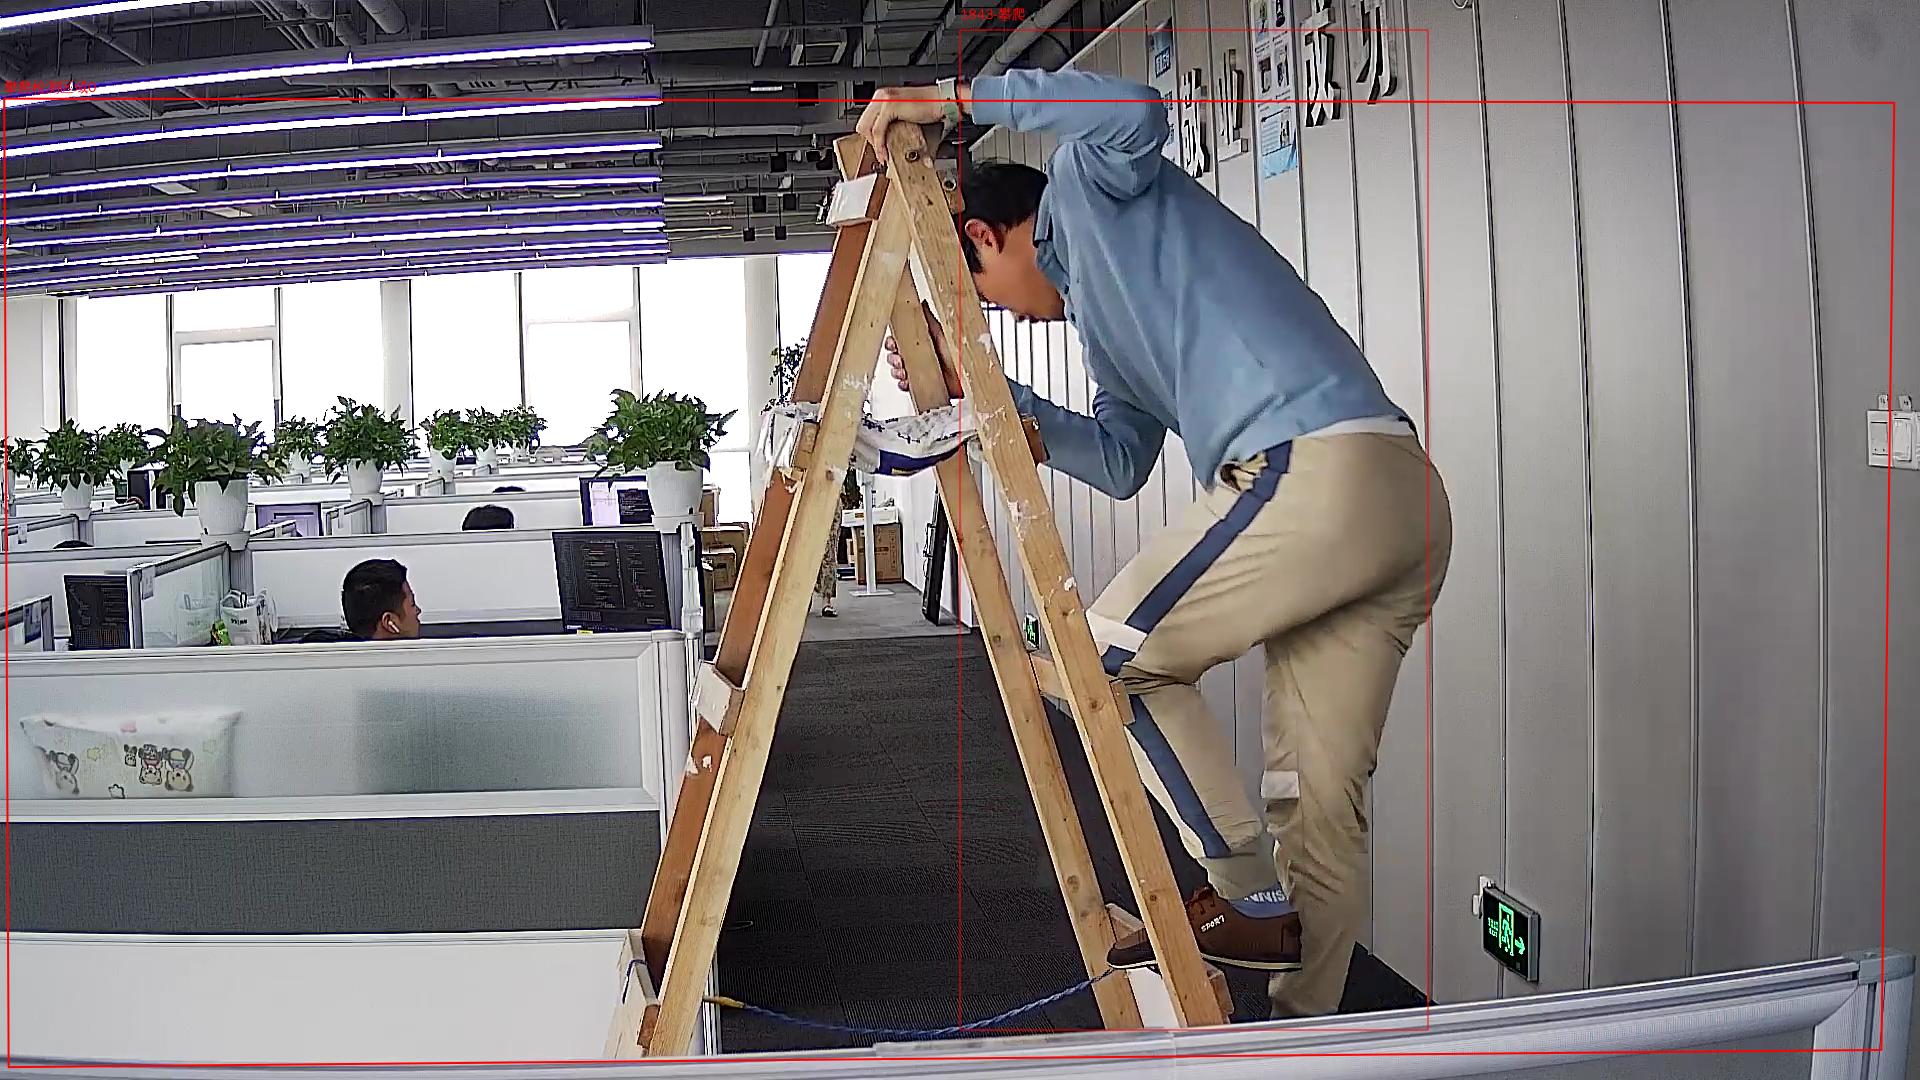
行为识别(人员闯入、聚众围观、逆行、非法逗留、值班离岗、抽烟、打电话、安全帽、车辆检测、跌倒等三十余种)

语音与语言类:
语音识别与语义理解
语音问答交互
数字人实时驱动
Transformer 架构大模型的本地推理


渲染类:
4K 画面渲染
3D 虚拟形象渲染
多 AI 任务并发

关键在于最后一条:多任务并发。RK3576 采用 4×Cortex-A72 + 4×Cortex-A53 异构架构,主频最高 2.2GHz,搭配 Mali G52 MC3 GPU,可以同时完成 4K 画面渲染、触控交互、外设驱动、AI 算法推理的多任务并发。
一台 AI 体测大屏在工作中要同时处理:摄像头采集、人体关键点识别、动作评分计算、界面渲染、触屏响应、语音播报。6TOPS NPU + 八核 CPU + 独立 GPU 的组合,才能让这些任务并发运行时"不带掉帧"。
三、6TOPS 的硬件载体:两款平台的差异化
视美泰旗下搭载 6TOPS NPU 的主力平台有两个:RK3576 与 RK3588。它们的 NPU 算力相同,但整体定位差异明显。
|
对比项 |
RK3576 平台 |
RK3588 平台 |
|
CPU |
4×Cortex-A72 + 4×Cortex-A53 @2.2GHz |
4×Cortex-A76 + 4×Cortex-A55 @2.4GHz |
|
单核性能 |
基准 |
相比 A72 提升约 30% |
|
多核性能 |
基准 |
相比 RK3576 提升约 20% |
|
GPU |
Mali G52 MC3 |
Mali-G610 MP4 |
|
NPU |
6 TOPS |
6 TOPS |
|
内存 |
标配4GB |
标配8GB |
|
视频解码 |
4K@120Hz |
8K@60Hz |
|
视频编码 |
4K@60Hz |
8K@30Hz |
|
解码路数 |
32 路 1080P@30fps |
32 路 1080P@30fps |
|
编码路数 |
16 路 1080P@30fps |
16 路 1080P@30fps |
核心结论:两款平台 NPU 算力持平,在行为识别、图像分析等边缘 AI 场景下表现相近。差异体现在三处:
- CPU 性能:RK3588 的 A76 大核在运行 AI 大模型这类偏重 CPU 调度的任务时更有优势,官方描述为"A76 大核更适合运行 AI 大模型"。
- GPU 与视频能力:RK3588 支持 8K 超高清视频编解码,适合视频分析类 AI 应用与高端显示场景。
- 内存带宽:RK3588内存带宽更高。这一点在大模型推理的长上下文场景下会被放大。
成本考量:RK3576 平台在性能足够的前提下更具性价比。对于绝大多数 4K 交互大屏、AI 体测、运动魔镜项目,RK3576 的 6TOPS 是更经济的答案。
四、6TOPS 的落地载体:三款主力产品
AIoT-3576EV:大屏专用,算力可扩展
面向商用交互大屏的专用 AI 终端主板,是视美泰旗下基于 RK3576 平台功能接口覆盖最全的 AI 大屏主板。


6TOPS 算力的实际应用:主板自带 6TOPS 原生 NPU 算力,原生支持 Transformer 大模型硬加速,本地即可流畅完成数字人实时驱动、人体体测、动作矫正识别、客流统计、语音问答等 AI 运算,无需依赖云端,交互零卡顿低延迟。
算力扩展能力:板载背面 M.2 固态扩展插槽,可直接接入算力协处理器实现算力二次扩容,满足 AI 体测一体机、AI 数字人终端、服务机器人等高算力设备的重度算法运行需求。
接口配置:7 路 USB、RS232/RS485/CAN 全规格工业总线、双千兆网口、M.2 M-Key(NVMe/SATA)、Wi-Fi6 + 蓝牙 + 4G/5G 模块位、双声道最高 10W 喇叭输出。
显示能力:V-By-One 或 HDMI-OUT 双通路支持 4K@120Hz;兼容 LVDS、eDP;支持双屏异显。
AIoT-3576SE:小体积,同算力
100×80mm 超小板型的小型嵌入式主板,同样搭载 RK3576 八核 + 6TOPS NPU。

这一点值得特别强调:AIoT-3576SE 用 100×80mm 的体积承载了与 AIoT-3576EV 相同的 6TOPS 算力。 支持 4K 超清输出、MIPI 摄像头接入、语音采集与播放,满足图像识别、语音交互、本地智能计算等需求。接口高度集成 HDMI、LVDS、eDP(可选)、MIPI DSI(可选)、喇叭、MIC、风扇、开关机、POE,一板搞定显示、音频、控制、联网全功能。
主板支持 12V 低压供电,待机电流低至 22mA,散热压力小。适合智能家居中控、小型网关、便携智能设备、穿戴配套终端。
AIoT-3588A:旗舰 6TOPS + 8K
RK3588 八核处理器(主频最高 2.4GHz)+ 6TOPS NPU。在保持同等 NPU 算力的前提下,提供了 8K@60Hz HDMI 输出、4 屏异显、HDMI 输入 4K@60Hz、M.2 SSD 与 SATA 扩展等更高阶的规格。


实际案例验证:在智慧停车场服务屏项目中,AIoT-3588A 需实时运行车牌识别、人脸检测、车辆跟踪、VR 导航渲染等多重 AI 算法。传统方案将视频流回传云端处理,存在延迟高、网络依赖强的问题。AIoT-3588A 凭借 6TOPS NPU 在本地完成 AI 推理,实现毫秒级响应,让"刷脸即导航"的体验真正流畅无感。


五、6TOPS 与云端算力的成本对比
很多客户会问:6TOPS 听起来不算高,为什么不直接用云端?
关键在于这是两种不同的算力模型。
云端算力是"租赁":按调用次数或计算时长付费,边际成本随设备数量与使用时长持续增长。设备铺得越多、用得越久,总成本越高,且这部分成本永远不会消失。
端侧 6TOPS 是"买断":一次性的硬件成本,之后每一次推理的边际成本接近于零。设备数量增加不会带来额外的算力费用。
对于设备规模在百台以上、日均交互次数在千次以上的项目,端侧 6TOPS 方案的总拥有成本通常会显著低于云端方案。再叠加断网可用、毫秒级延迟、数据不出设备这三项云端方案无法提供的能力,选型结论就非常清晰了。
六、6TOPS 选型检查清单
采购或选型时,建议按以下清单逐项确认:
算力侧:
NPU 标称算力(例如 6TOPS)是否在 INT8 精度下测得?
是否原生支持 Transformer 大模型硬加速?(这是跑大模型的前置条件)
是否有算力扩展通道(如 M.2 算力协处理器插槽)?
GPU 型号与视频编解码能力是否匹配项目的显示需求?
内存侧:
内存容量是否覆盖"模型权重 + KV Cache + 素材缓存"?建议 6GB 起,8GB 更稳妥
内存类型直接影响大模型推理速度
接口侧:
USB 路数是否够接全部外设?(多外设项目建议 7 路起)
串口是否涵盖 RS232/RS485/CAN?数量是否满足?
网口数量与是否支持物理隔离?(AI 体测、服务机器人场景通常需要双网口)
显示接口是否覆盖项目选用的屏幕规格?
是否有 M.2 / SATA 存储扩展通道?
系统与可靠性侧:
支持的操作系统清单是否覆盖团队技术栈?
是否通过高温老化、静电抗扰、扫频振动、反复掉电测试?
是否满足 7×24 小时不间断运行要求?
是否具备完善的系统调用接口 API 与参考代码?
七、结语
6TOPS 不是终点,而是端侧 AI 真正可商用的起点。它让 AI 数字人、运动魔镜、AI 体测一体机、智能交互标牌这些产品第一次可以在不依赖云端的条件下,把完整体验交给终端本地完成。
视美泰基于 RK3576 与 RK3588 平台的 AI 终端主板,正是围绕 6TOPS 这一算力等级打造的完整硬件矩阵——从 100×80mm 的轻量化小板到支持 8K 输出的旗舰型号,从可扩展算力的 M.2 插槽到覆盖全场景的外设接口。

