
-
-
信息发布
-
门禁考勤
-
访客预约
-
会议预约
-
智慧监控
-
企业数智化
-
信息发布
-
-
公司介绍
-
企业动态
-
招标公告
-
联系我们
-
公司介绍
从听见到看懂:音视双重校验如何把告警误报降下来
告警系统的痛点,从来不是"检测不到",而是"报得太多"。
传统视频监控方案易受环境干扰,树叶摆动、光影突变等非目标事件极易触发无效告警;纯音频监测系统则难以区分目标声源与环境背景噪声,同样存在大量误触发问题。海量虚警会占用运维人员大量复核精力,导致真正高优先级的风险事件被淹没,严重降低整套系统的实用价值。
一、音视双重特征联合触发告警机制
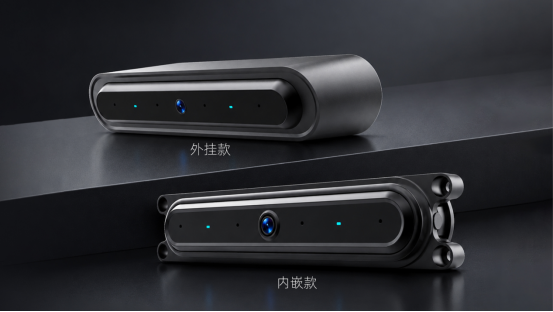
视美泰推出的多模态语视模组AIoT-M-F01采用“图像、音频双重特征同步匹配“的告警判定逻辑:只有当视觉感知与音频感知同时捕获对应事件特征,才会输出有效告警信号。
- 视觉检测到人员长时间在设备区域滞留,同时音频识别到求助人声,才判定为需要人工介入的紧急事件;
- 视觉识别设备外观、运行画面出现异常,同时音频采集到设备异响噪声,才判定为设备故障事件。
该机制可过滤绝大多数单模态带来的虚假告警,大幅削减后端人工复核的工作量,提升告警事件有效命中率。
二、超越目标检测:实现画面‑语音的事件因果关联理解
区别于传统单模态设备仅能完成 “是否出现目标对象” 的基础检测,M‑F01 多模态模组可对“视觉画面内容与音频语音语义做融合解析”,完成事件因果关联推理,实现从 “检测对象” 到 “理解事件” 的能力升级,该能力是单视觉或者单音频方案无法实现的。举几个典型例子:
|
场景 |
画面特征 |
语音特征 |
判定事件 |
|
养老陪护 |
老人倒地 |
呼救语音 |
紧急事件 |
|
工业制造 |
设备异常画面 |
设备异响 |
设备故障 |
|
零售商业 |
顾客看向货架 |
询问价格 |
购买意向 |
|
车载座舱 |
驾驶员面部疲劳 |
口述犯困 |
联动提醒策略 |
这些"画面行为 + 语音内容"的因果关联,是单模态方案做不到的。

三、工程意义:降低无效运维,提升系统可信度
面向AI服务机器人、数字人、AI智能体等商用、工业级终端场景,告警误报率的降低具备明确工程与业务价值:通过音视多模态融合校验,减少无效告警输出,直接降低运维人力复核成本,减少不必要的现场处置出勤,同时提升终端告警系统输出结果的可信度,强化整套 AI 监测方案的实际落地能力。

